可靠性 Reliability
保证关键用户流程可用,并在约定范围内恢复。用 SLO 定义服务质量、RTO 定义恢复时间、RPO 定义可接受的数据丢失;分析依赖故障,消除单点并验证恢复能力。
- 示例
- 让门户跨可用区运行,对短暂依赖故障采用有上限的重试,并演练数据库还原,确认整个服务达到恢复目标。
- 取舍
- 额外副本与备用区域会增加成本和运营复杂度,应依据停机对业务的影响决定投入。
关于跨平台云治理的一些实践与思考。
从平台选型延伸到持续运营,而不只是把工作负载搬上云。
我在 GCP、AWS、Azure、阿里云和 OpenStack 的治理中积累了成熟的实践。面对不同云平台,我更关注一套可落地、可持续调整的治理方式:明确业务目标与责任边界,建立平台基线,再用策略、安全、成本和运营反馈持续改进。
借鉴其 Strategy、Plan、Ready 到 Govern、Secure、Manage 的路径,把业务目标、平台准备和治理运营连成闭环;方法论用于指导多云实践,而不是照搬 Azure 的实现细节。
以可靠性、安全性、成本优化、卓越运营和性能效率五个支柱审视工作负载,在取舍中平衡风险、体验与投入。
这些框架提供检查问题的视角;实际治理仍需结合各平台能力、组织约束与工作负载特点。
以 Cloud Adoption Framework(Microsoft Learn,在新标签页打开) 为参照。它是 Azure 指南,其中的组织决策思路也可用于 AWS、GCP、阿里云与私有云的采用实践。
CAF 连接业务目标、组织准备与云交付。战略、规划、就绪与采用构成初始路径;治理、安全与管理需要提前规划,并贯穿采用与运营全程。需求变化时应重新审视之前的决策。以下以假设的客户门户为例。
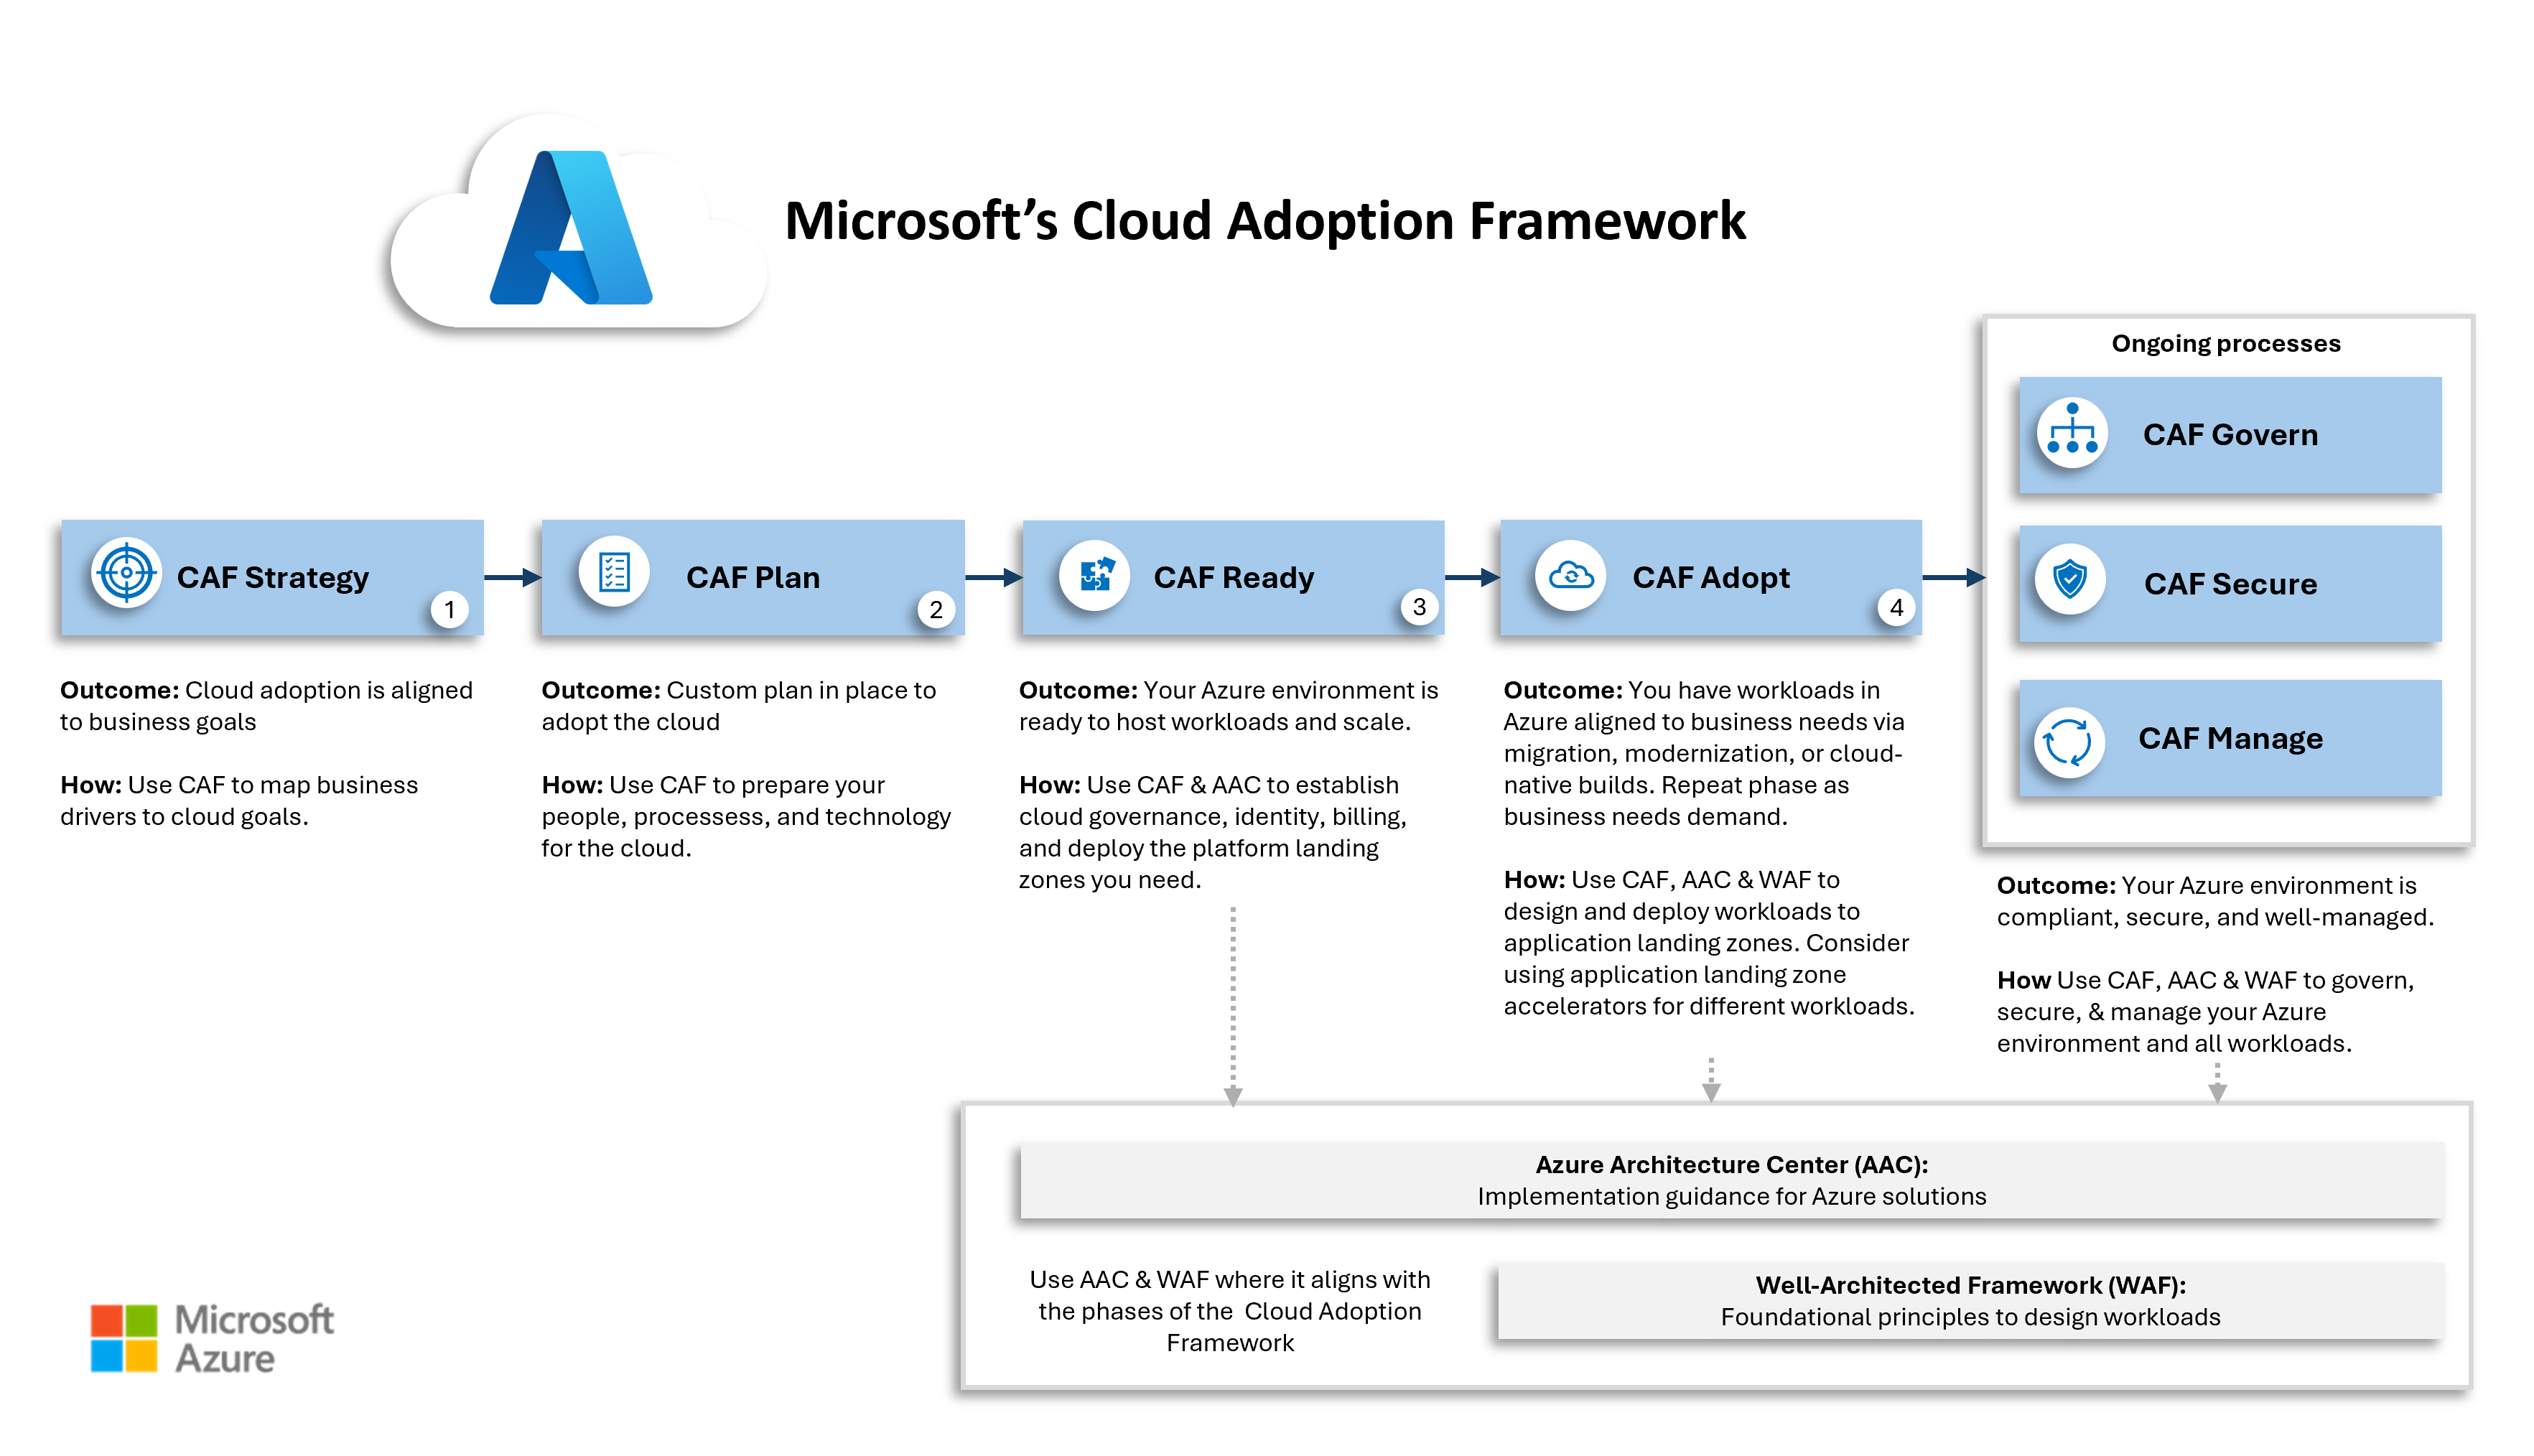 查看完整尺寸图(在新标签页打开)
云采用 · 依次推进
运营 · 并行持续
Azure 架构中心提供实现指导,良好架构框架提供工作负载设计原则,两者共同支持云就绪、采用与持续运营。
先把云投入与业务成果关联,再选择服务。让业务、财务、IT 与安全负责人共同确定上云动机、范围、风险容忍度与可衡量的成功标准。
把战略转化为可执行的路线图。盘点应用、数据与依赖关系,评估云就绪程度和技能缺口,估算成本,并明确平台团队与工作负载团队的职责。
在部署业务前搭建可重复交付的着陆区。区分共享平台服务与工作负载环境,通过基础设施即代码建立身份、网络连接、账号结构、策略、日志与计费基线。
根据业务价值与技术约束迁移、现代化或新建工作负载。逐个应用选择路径,验证功能与性能,规划数据传输、切换、回退与运营交接,并随需求变化重复推进。
把业务风险与合规要求转化为可执行策略。规定允许的区域、资源归属、支出控制与例外处理方式,并随云规模增长持续检查合规状态。
以零信任贯穿整个生命周期:明确验证、最小权限、假设已被入侵。结合身份控制、网络隔离、数据保护、漏洞管理、威胁检测与事件响应。
上线后持续维护服务健康。约定服务与恢复目标,监控用户体验和平台状态,维护备份与补丁,明确值班责任、操作手册与持续改进机制。
在多云环境中,每个平台各有着陆区实现,但战略、治理、安全与运营标准应当统一,避免各云各管一套。
以 Well-Architected Framework(Microsoft Learn,在新标签页打开) 为参照。CAF 确立组织方向与平台标准;WAF 指导工作负载在这些标准内的设计与运营。
五个支柱之间存在取舍:没有工作负载能在每一项都做到极致。组织应根据业务关键程度、合规要求和上线时间,决定每个支柱投入多少。示例沿用 CAF 阶段中的假设客户门户;数字目标仅用于说明,实际目标需与业务共同约定。
保证关键用户流程可用,并在约定范围内恢复。用 SLO 定义服务质量、RTO 定义恢复时间、RPO 定义可接受的数据丢失;分析依赖故障,消除单点并验证恢复能力。
根据工作负载风险保护机密性、完整性与可用性。进行数据分级和威胁建模,落实最小权限、隔离、敏感数据加密与攻击监测,并规划事件遏制与恢复方式。
在可持续预算内交付业务价值。把计算、存储、网络传输、许可与运营纳入总成本模型,明确费用负责人,跟踪每笔有效业务交易的成本,并按实测需求调整容量和计费方式。
让开发与运营可重复、可观测且变更安全。采用版本化基础设施、自动化测试与部署、清晰的职责、可行动的监控信号和事件手册,把生产反馈转化为改进。
随需求变化持续满足用户体验。为关键流程设定延迟与吞吐目标,测量完整请求路径,模拟真实负载进行压测,并针对实际瓶颈选择伸缩和数据访问方案。
落地方法:先理解各支柱设计原则,再按业务优先级处理检查清单,明确记录取舍,并用成熟度模型分阶段改进,把评估当作随工作负载演进的动态分数。